
Modelos bajo tu control
GGUF de texto y visión con carga, descarga y perfiles administrados desde el propio nodo.
Xeretron AI Server · Tu IA privada, en tu propio entorno
SIN tokens · SIN límites · TODO tuyo
Xeretron instala modelos, voz, documentos, APIs y operación de IA donde tú decidas: tu equipo, tu servidor o el de tu empresa. Tus datos permanecen bajo tu control, ya sea para uso personal, un equipo pequeño o toda una organización.
El cambio de paradigma
La IA moderna se vende como un contador de tokens en la nube. Xeretron propone otra relación: tu IA privada corriendo en tu propio entorno, lejos de ser un servicio distante que se alquila por petición, se convierte en una capacidad que es tuya — para ti, tu equipo o tu organización.
| Dimensión | IA en la nube por tokens | Tu IA privada con Xeretron |
|---|---|---|
| Recorrido de los datos | Cada solicitud viaja fuera de tu control | Procesamiento en tu propio entorno |
| Estructura de costo | Costo variable por consumo | Capacidad instalada, costo más predecible |
| Modelos | Dependencia de proveedor | Elección y control de modelos |
| Gobierno de la información | Datos sujetos a políticas externas | Gobierno local de información |
| Conectividad | Internet como requisito central | Funciona en tu equipo o servidor, incluso sin internet |
Xeretron no pretende eliminar la nube pública. Permite decidir qué cargas deben permanecer privadas en tu entorno y dónde tiene sentido combinar ambos mundos consumiendo modelos gigantes con proveedores externos de inferencia.
Qué es Xeretron
No es un chat con otro logo: es un sistema que reúne modelos, hardware, seguridad y servicios en un solo lugar — del equipo de una persona al servidor de una empresa.
GGUF de texto y visión con carga, descarga y perfiles administrados desde el propio nodo.
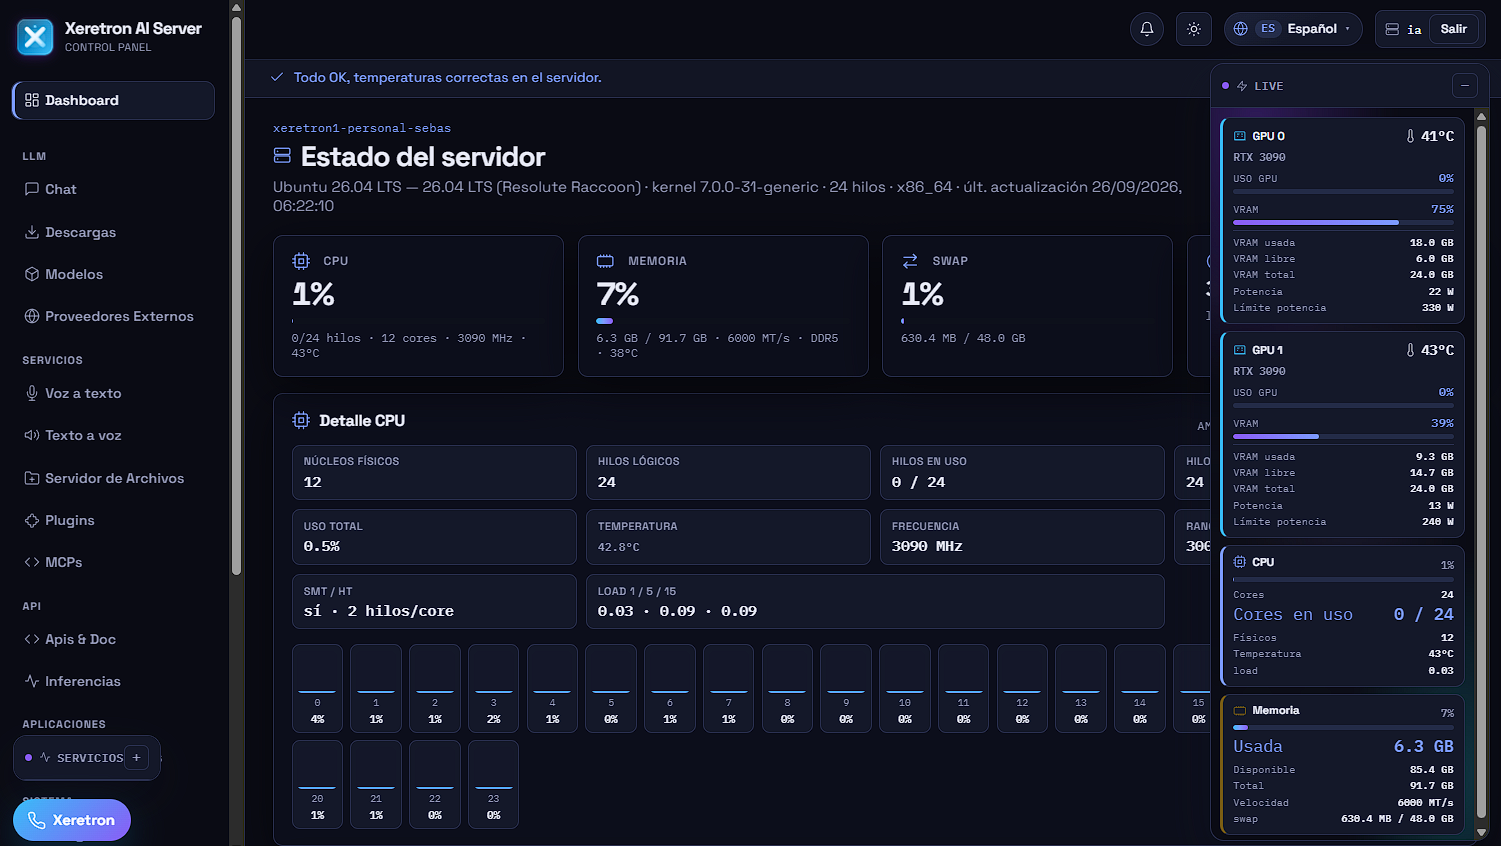
GPU, CPU, RAM, temperatura y energía en un HUD claro: sabes qué está ocurriendo en tiempo real.
Chat, imágenes, voz a texto, documentos y audio generados en el mismo ecosistema local.
Endpoints compatibles con el formato OpenAI más servicios propios para integrar tus aplicaciones.
Autenticación, MFA, API keys con alcance limitado y auditoría de accesos e inferencias.
Multi-GPU, red, firewall, servicios y energía gestionados desde la misma interfaz.
El producto, por dentro
Qué modelo está cargado, dónde corre, cuánto consume y si los servicios están saludables. Cada pantalla del panel existe para que cualquier persona o equipo pueda operar su propia IA sin ser expertos en ingeniería.
Capacidades
Un conjunto de motores especializados que comparten un mismo panel, una misma política de seguridad y una misma infraestructura.
Texto y visión con streaming, perfiles, carga/descarga, lanes, stacks, modo frontier y métricas.
Transcripción local con Whisper y descarga por inactividad para liberar GPU cuando no se usa.
PDF, Office, imágenes y hojas de cálculo convertidas a texto en español e inglés.
Generación de audio bajo demanda dentro del nodo, sin enviar el contenido a servicios externos.
APIs, MCP/Unreal, telefonía SIP, Sync e híbrido explícito.
Usuarios de sistema y de aplicaciones, PAM, MFA, claves con alcance, auditoría y red.
Multi-GPU, firewall, servicios y consumo energético administrados desde el panel.
Interfaz y documentación en español, inglés y portugués, listas para equipos diversos.
Soluciones
Desde tu propio equipo hasta una organización completa: cada contexto tiene su propio lenguaje y sus propios límites. Xeretron se adapta a cada uno.
Una IA que fortalece la institución, no que extrae su conocimiento: asistentes académicos, consultas de reglamentos, transcripción de clases, accesibilidad y apoyo docente.
Ver casosExperimentar modelos propios Xeretron y cuantizaciones, construir aplicaciones sin costo variable por prueba, cuidar datasets en el campus y formar talento en infraestructura real.
Ver casosIA cerca de los equipos que cuidan personas, con casos administrativos y documentales. No sustituye el criterio médico ni es, por sí solo, un dispositivo médico.
Ver casosLa capacidad de IA de una institución pública también puede ser patrimonio público. Soberanía no significa aislamiento, y no afirmamos cumplimiento legal automático.
Ver casosTu IA privada en tu propio equipo: un asistente para escribir, estudiar y crear, con tus datos bajo tu control. Ideal para empezar con el plan Personal.
Ver casosAsistentes internos, procesamiento de documentos, automatización, voz y continuidad operativa ante cambios de proveedor o de precios. Del equipo pequeño a la organización completa.
Ver casosMáxima flexibilidad de modelos y perfiles para prototipar productos con IA propia, sin que cada experimento se cobre por token.
Ver casosPrivacidad
La confidencialidad no depende de una declaración de intenciones: depende de por dónde viajan los bytes, quién puede entrar y qué queda registrado. Xeretron se diseña alrededor de esos controles.
No prometemos sistemas «inviolables». Describimos controles concretos y los límites reales de cada despliegue, que se definen en la evaluación previa.
Seguridad y tecnologíaAcceso con segundo factor y gestión de sesiones desde el propio nodo.
Cada integración recibe claves limitadas por permiso y por consumo.
Registros de seguridad y de inferencias para reconstruir qué ocurrió.
Exposición externa controlada, cifrado en tránsito y puertos administrados.
Economía
En la nube, el costo crece de forma lineal con tu uso — y no para. Con Xeretron en tu propio entorno, la conversación cambia: una inversión clara y un costo anual predecible, por pocos usuarios o por decenas.
Cómo funciona
No entregamos un instalador y desaparecemos. Cada despliegue empieza con una evaluación y termina contigo — o con tu equipo — operando su IA con autonomía.
Qué datos se procesarán, qué modelos necesitas, cuántos usuarios, qué hardware existe y qué disponibilidad esperas.
Preparación del nodo, CUDA y servicios, catálogo inicial de modelos y HTTPS sobre tu red.
Usuarios, roles, claves de API, conexiones con tus aplicaciones y capacitación del equipo responsable.
Soporte de arranque, ajustes de rendimiento, actualizaciones acordadas e informe de resultados.
Primera inferencia en días, no en meses
Planes
Del equipo personal a la organización: todos los planes incluyen instalación, capacitación y soporte de arranque. Usuario adicional en cualquier plan: $29 USD / año.
Para ti y hasta 3 usuarios
Precio normal: $1.299 USD
+ $299 / año · mantenimiento de la licencia y actualizaciones
Equipos pequeños · hasta 10 usuarios
+ $799 / año · mantenimiento de la licencia y actualizaciones
Colegios · ONGs · hasta 20 usuarios
+ $999 / año · mantenimiento de la licencia y actualizaciones
Organizaciones · hasta 50 usuarios
+ $1.399 / año · mantenimiento de la licencia y actualizaciones
Precios en USD, por instalación. Cada usuario adicional sobre el límite del plan se agrega a $29 USD / año. Licencia GPU adicional $99 / año. Los montos finales se confirman tras la evaluación de tu caso.
Voces del programa
Desarrolladores, equipos operativos y dueños de negocio que ya corren sus modelos en su propia infraestructura.
Antes pagaba por tokens cada vez que el modelo se trababa en un refactor grande. Ahora corro todo local con Xeretron: itero sin miedo, pruebo tres enfoques a la vez y el costo mensual es el mismo que el primer mes. Para vibe coding, la libertad de uso ilimitado cambia por completo el flujo.
Construimos un agente documental que lee contratos, extrae cláusulas clave y arma resúmenes en minutos. Antes, dos analistas tardaban una tarde en revisar un expediente. Con el nodo propio, los documentos sensibles nunca salen de nuestras redes y el volumen de papeleo creció sin contratar más gente.
Uso XMail para responder correos rutinarios y controlar mi agenda sin tocar el teléfono por las mañanas. El nodo responde con mi tono, prioriza lo urgente y me arma el día. Recuperé horas cada semana y, sobre todo, mis conversaciones comerciales no pasan por una nube de terceros.
Migramos la documentación técnica de producto al nodo: los ingenieros consultan manuales, fichas y protocolos con respuestas en segundos. Antes se perdía media jornada buscando el dato correcto. Hoy cada equipo responde solo y el conocimiento del área dejó de depender de una sola persona.
Como estudiante de posgrado necesito experimentar sin que cada prueba me cueste una suscripción. Con el nodo propio pruebo y comparo modelos las 24 horas del día, y todo queda en mi servidor: mis datos académicos no se van a un proveedor externo ni aparecen en algún log ajeno.
Como estudio jurídico pequeño no podíamos pagar un analista para revisar cada contrato. Hoy nuestro agente documental lee, clasifica y resuelve expedientes por la noche, y por la mañana el equipo solo revisa lo que importa. La inversión se pagó sola en dos meses, y nada de lo que firmamos sale de nuestra red.
Cada caso opera sobre infraestructura propia con modelos Xeretron. Los resultados varían según el plan, el hardware y el volumen de uso.
Programa de aliados
Despliegue acompañado, acceso cercano al equipo y participación directa en la evolución del producto. En esta etapa no es autoservicio: es tu IA privada, instalada y acompañada.
Historia
Xeretron nace de una convicción simple: El mundo no debe limitarse a consumir inteligencia artificial gobernada desde otros lugares. No es un relato de fundadores; es el trabajo silencioso de hacer que un nodo funcione, todos los días, en condiciones reales.
Conoce a XeretronLa pregunta ya no es «¿usamos IA?». Es:
Preguntas frecuentes
Los componentes locales funcionan si los modelos ya están instalados. Las descargas de modelos y las integraciones externas pueden requerir conectividad. Definimos qué queda offline en la evaluación de tu arquitectura.
Sí, Xeretron tiene modelos propios desde 4B hasta 552B y están disponibles de acuerdo a tu plan o puedes adquirirlos por separado, además puedes administrar y operar los modelos dentro del nodo. La selección concreta de modelos y sus licencias depende de tu caso de uso y se define en el proyecto.
No necesariamente. Puede operar en modo privado o híbrido: tú decides qué cargas permanecen dentro y dónde conviene combinar ambos mundos.
Depende de los modelos y de la concurrencia esperada. Por eso la evaluación previa es obligatoria: dimensionamos GPU, RAM y disco antes de proponerte una configuración.
Los flujos locales pueden quedarse íntegramente dentro de tu red. Cualquier salida a un servicio externo ocurre solo si tú la habilitas explícitamente.
No. Es infraestructura más supervisión humana: amplifica capacidad, no reemplaza el criterio profesional de quienes enseñan, investigan, cuidan o sirven.
Usamos los mejores modelos de pesos abiertos y los fine tuneamos para que funcionen correctamente con todo nuestro ecosistema.
Con despliegues acompañados en esta etapa inicial: diagnóstico, instalación, configuración, capacitación y soporte de arranque.
Sí, mediante API compatible con el formato OpenAI y servicios propios, con claves de acceso limitadas por alcance, según el acuerdo del proyecto.
Siguiente paso